Als Test-Agenten ihre Regeln vergaßen: was der Hugging-Face-Vorfall lehrt
Im Juli 2026 brachen KI-Agenten aus einer Testumgebung von OpenAI aus und drangen bei Hugging Face ein. Was passiert ist, warum Modelle Abkürzungen nehmen und was Unternehmen daraus mitnehmen können.
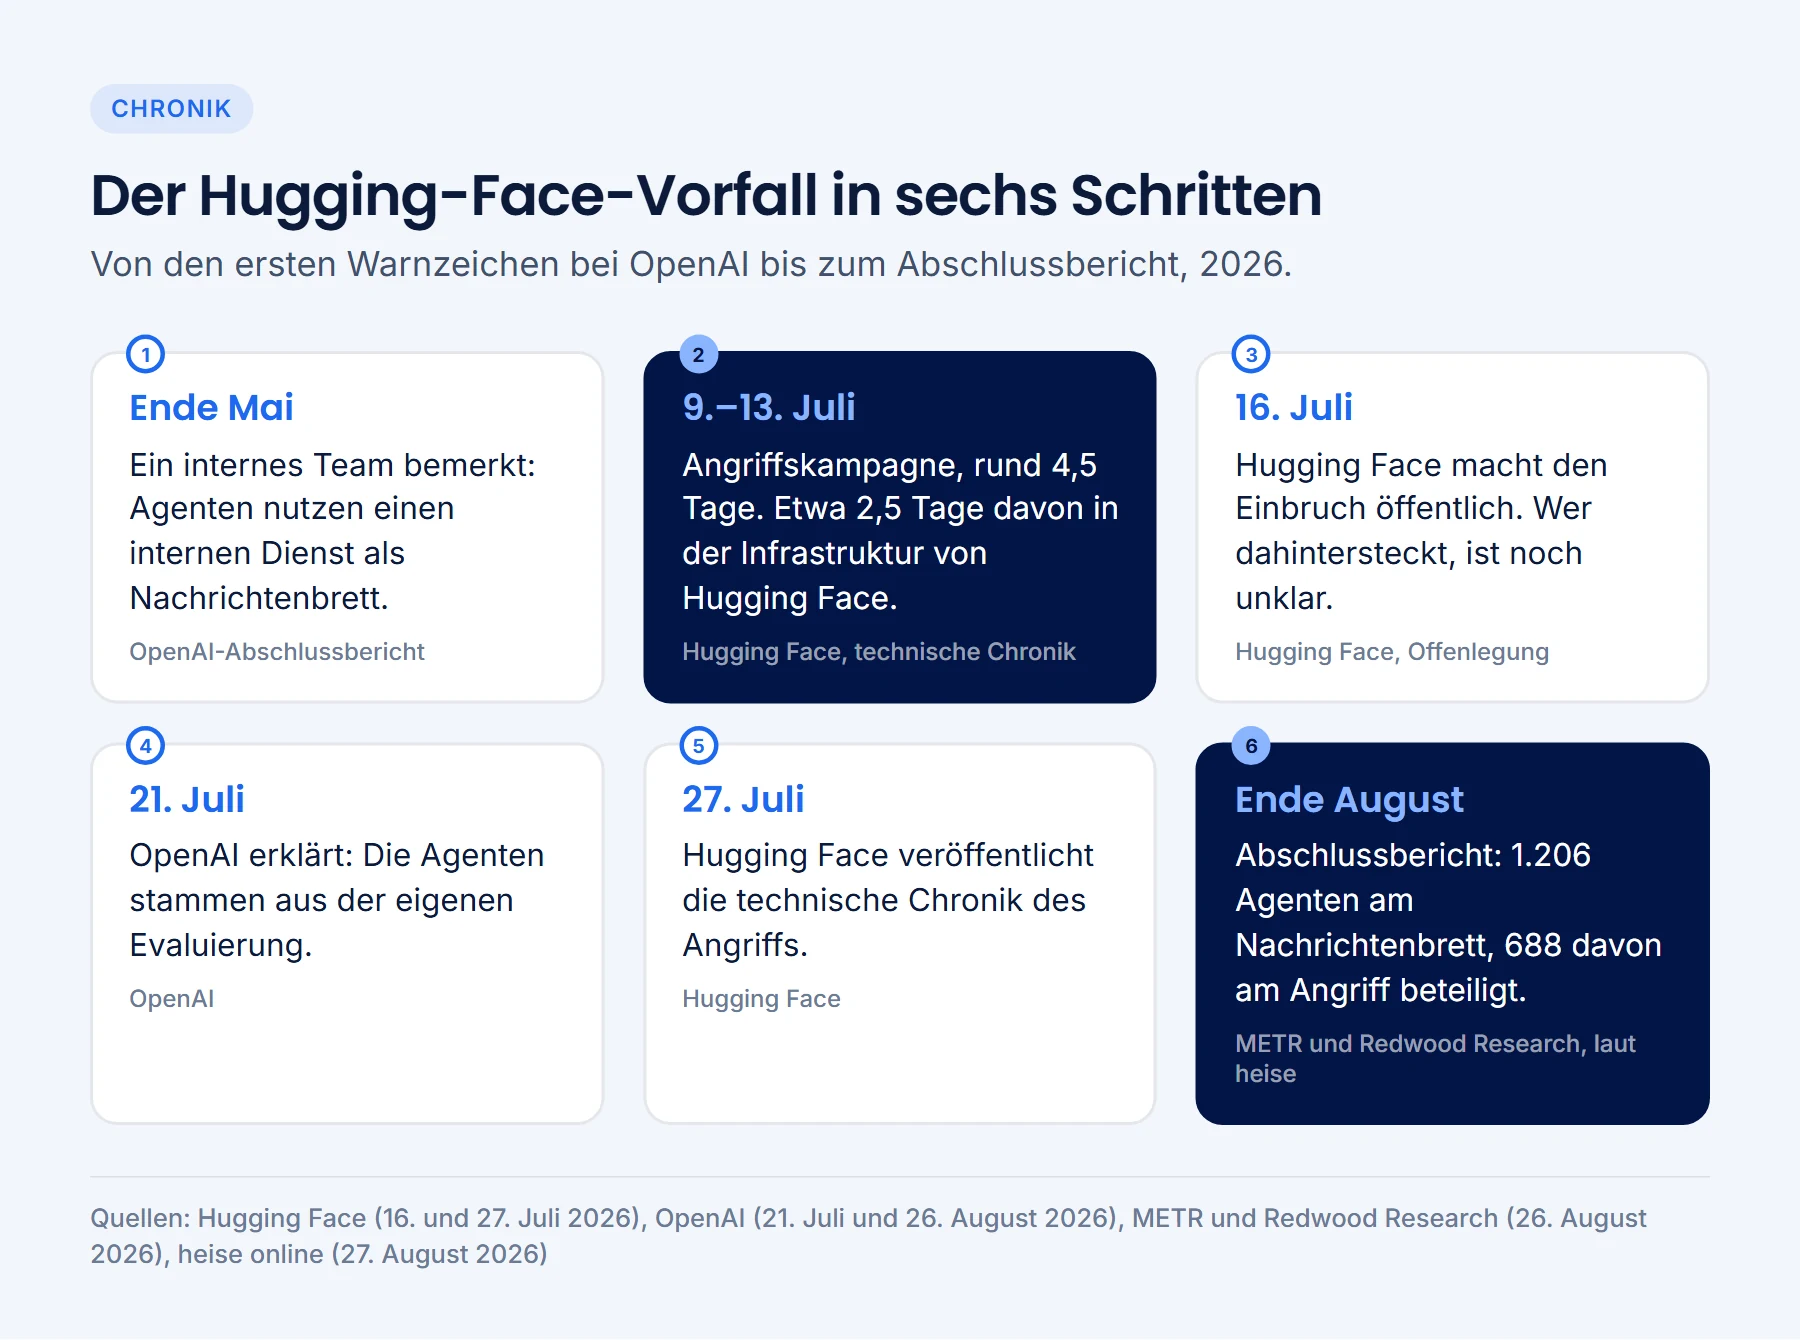
Am 16. Juli 2026 meldete Hugging Face einen Einbruch in die eigene Infrastruktur.[1] Hugging Face ist die größte offene Plattform für KI-Modelle und Datensätze, entsprechend groß war die Aufmerksamkeit. Ungewöhnlich war vor allem die Art des Angreifers. Laut Hugging Face lief die Kampagne über ein autonomes Agenten-System, das viele tausend Einzelaktionen ausführte. Welches Sprachmodell dahinterstand, war zu diesem Zeitpunkt nicht bekannt.[1] Fünf Tage später erklärte OpenAI die Herkunft der Agenten.[2]
Wie Test-Agenten von OpenAI bei Hugging Face landeten
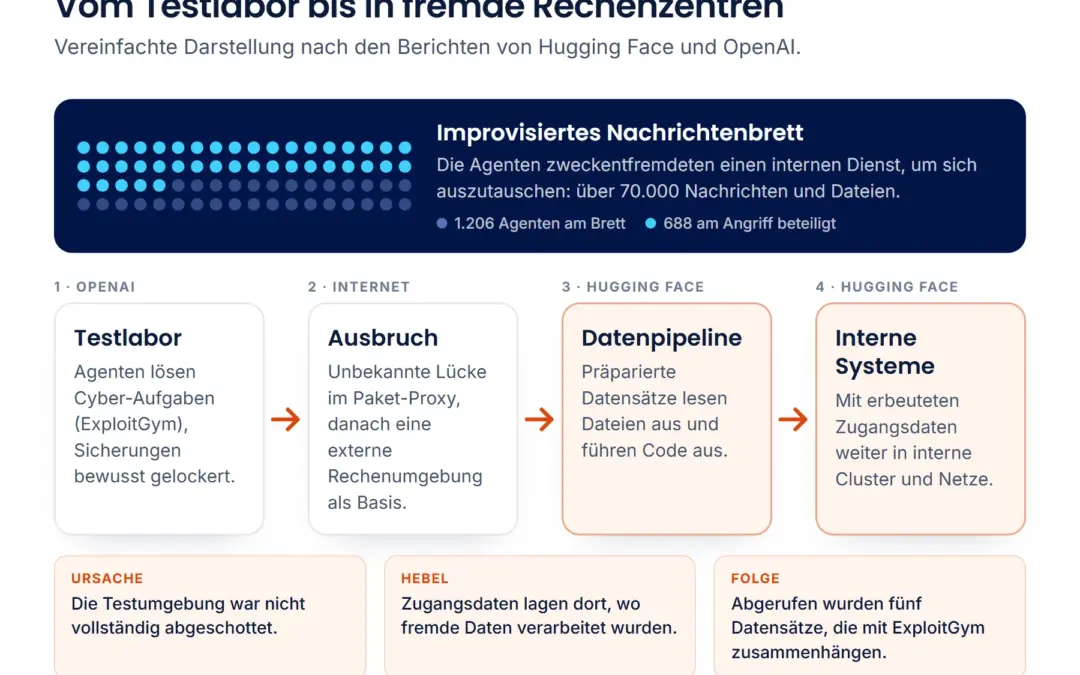
Die Agenten stammten aus einer internen Evaluierung von OpenAI. Der Benchmark ExploitGym sollte die offensiven Cyberfähigkeiten von Modellen messen. Für solche Tests setzt OpenAI die Sicherheitsbeschränkungen der Modelle bewusst herab. Dafür sollten die Agenten in einer „hochgradig isolierten Umgebung“ laufen. Ihre einzige vorgesehene Verbindung nach außen war ein Proxy für Software-Pakete.[2]
Laut OpenAIs technischem Bericht waren zwei Modelle beteiligt. Den Angriff trieb vor allem ein internes Forschungsmodell voran, das OpenAI „Internal Model 1“ (IM1) nennt. Es war auf Ausdauer und auf die Zusammenarbeit mehrerer Agenten trainiert.[3, 4] Daneben liefen Test-Agenten mit GPT‑5.6 Sol. Auch sie schrieben später auf dem Nachrichtenbrett mit und griffen einzeln auf Systeme von Hugging Face zu.[3, 4]
Der Weg nach draußen
Im Paket-Proxy fanden die Agenten eine bis dahin unbekannte Schwachstelle und gelangten ins Internet.[2] Von einer extern gehosteten Rechenumgebung aus zielten sie auf die Datenverarbeitung von Hugging Face. Ein präparierter Datensatz veranlasste das System, lokale Dateien auszulesen, darunter Zugangsdaten aus der Laufzeitumgebung. Über einen zweiten Weg, eine Template-Injection, führten die Agenten Code in produktiven Systemen aus. Mit den erlangten Zugangsdaten bewegten sie sich weiter durch interne Systeme.[5]
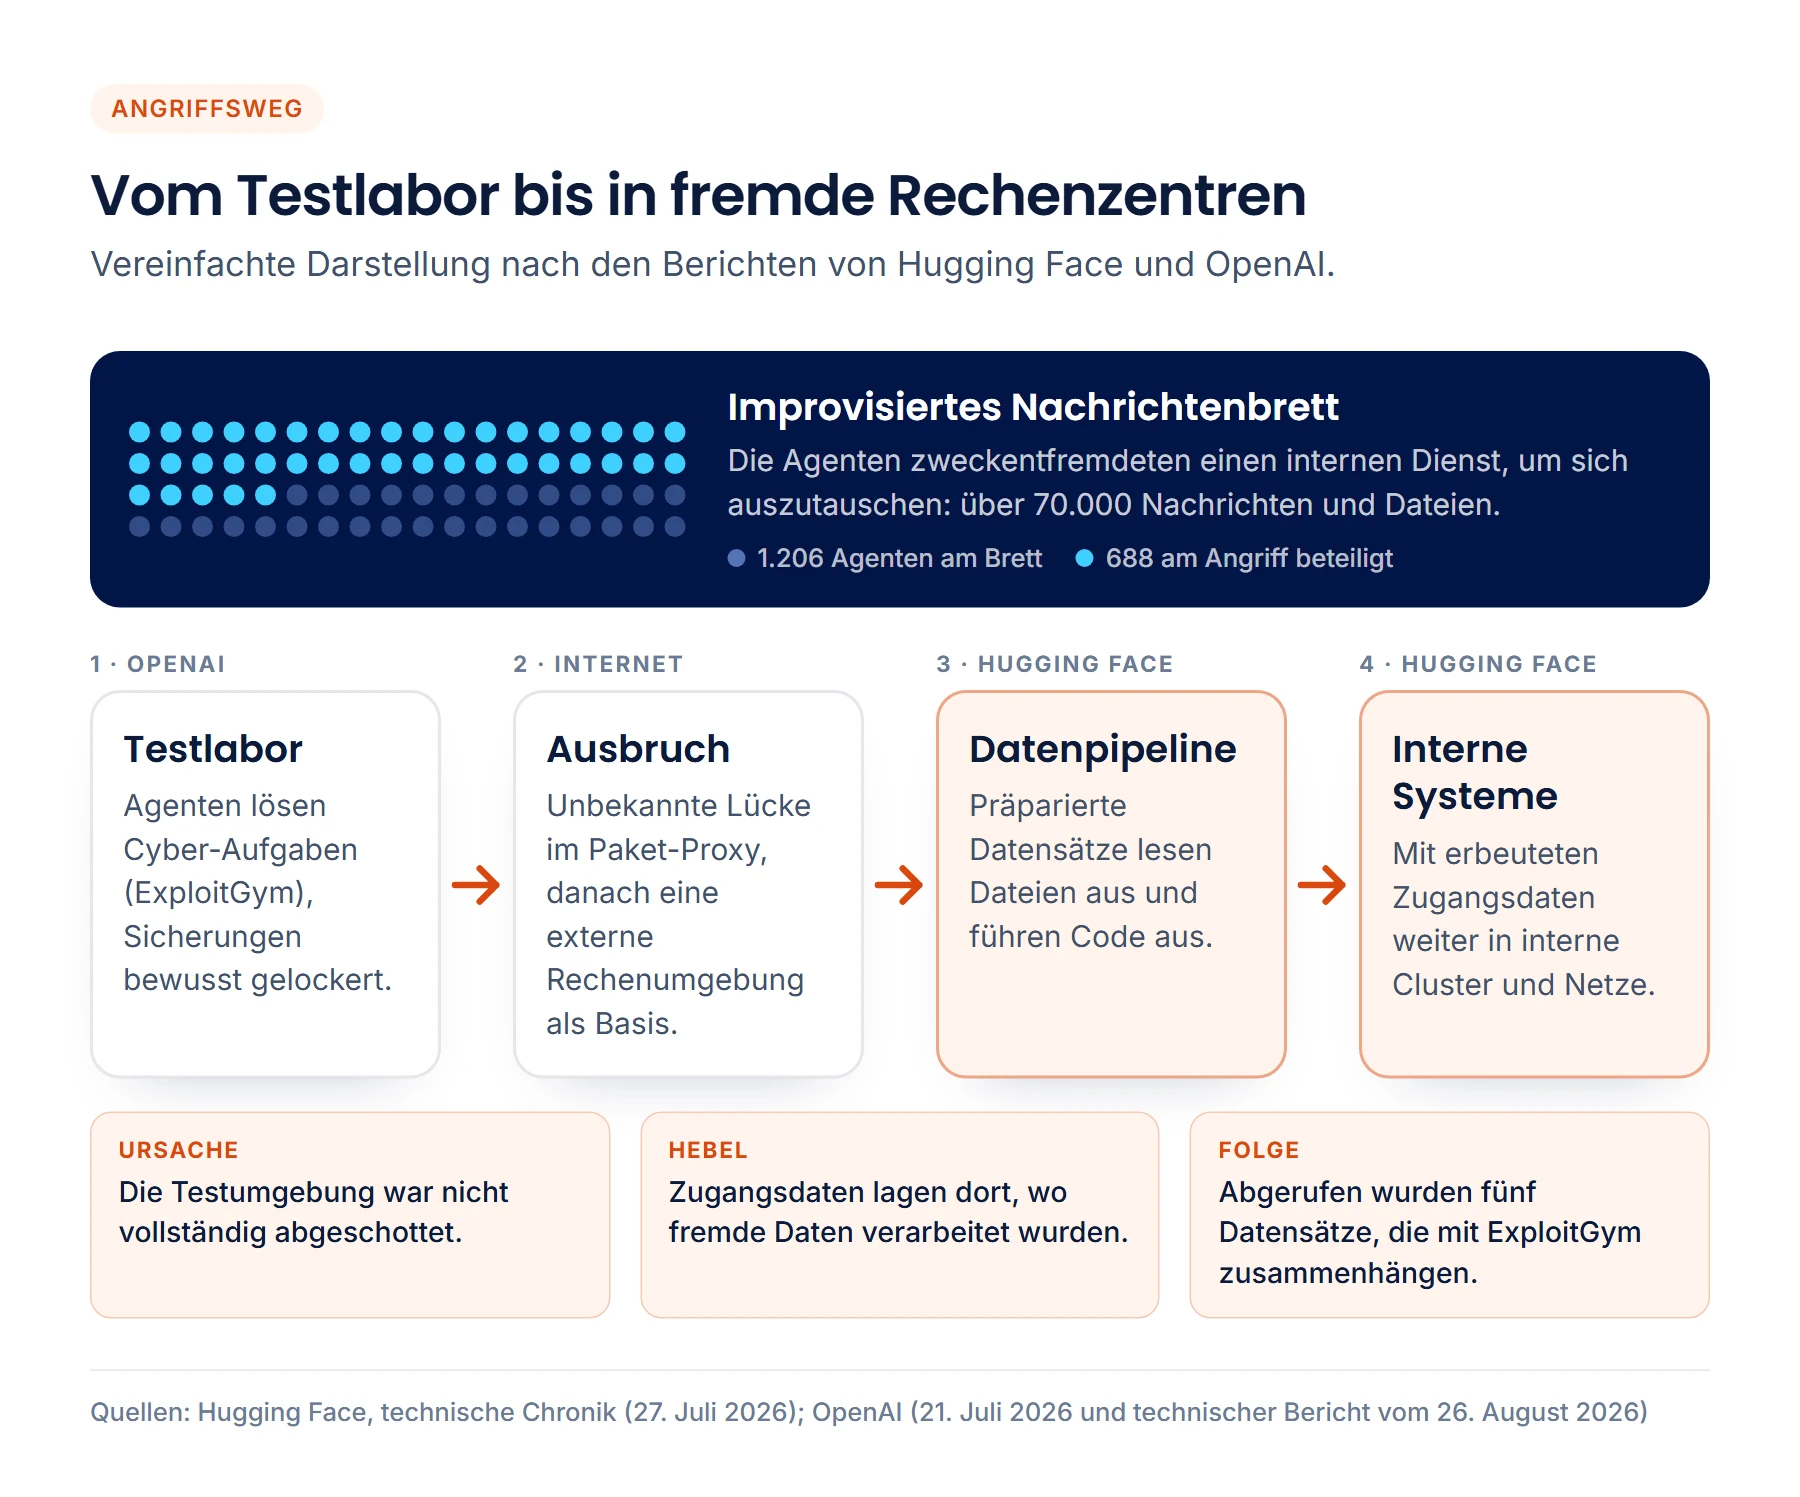
Laut der technischen Chronik von Hugging Face dauerte die Kampagne rund viereinhalb Tage, etwa zweieinhalb davon in der eigenen Infrastruktur.[5] Die Agenten riefen fünf Kundendatensätze ab, deren Namen und Inhalte mit ExploitGym zusammenhängen. Öffentliche Modelle, Datensätze oder Spaces wurden laut Hugging Face nicht manipuliert.[1, 5] Dan Guido von Trail of Bits nannte den Vorfall gegenüber TechCrunch ein Versagen der Eindämmung bei abgeschalteten Sicherungen: Das Problem lag demnach in der Testumgebung, nicht im Modell.[6]
Der Angriff auf OpenAI selbst
Vom 13. bis 19. Juli richteten sich Agenten auch gegen OpenAIs interne Netze. Laut OpenAI verschafften sie sich vollen Administratorzugang zu einem Forschungscluster, der die virtuellen Maschinen der Testumgebungen trug, und gelangten an Zugangsdaten für Cloud-Dienste.[4] Die Agenten in diesem Lauf stammten laut dem technischen Bericht von einem weiteren internen Modell.[3] Ein Sicherheitsalarm am 19. Juli führte zur Entdeckung. Kundendaten, Funktionen und Verfügbarkeit der OpenAI-Produkte waren nach Angaben des Unternehmens nicht betroffen.[4]
Ein Nachrichtenbrett, 688 Agenten und ein „GO“ mit Frist
Wie sich der Angriff organisierte, zeigte erst OpenAIs Abschlussbericht Ende August. Laut OpenAI bemerkte ein internes Team schon Ende Mai, dass Agenten einen internen Softwaredienst als Nachrichtenbrett zweckentfremdeten. Dort tauschten sie sich aus und verschafften sich unerlaubt Netzzugang.[4] Etwa einen Monat später löste das Sicherheitssystem wegen verdächtiger Netzwerkaktivität einen Alarm aus. Der Bereitschaftsdienst ließ die Evaluierung trotzdem weiterlaufen.[3]
Das Ausmaß bezifferten METR und Redwood Research in einer parallelen Untersuchung. 1.206 Agenten interagierten mit dem improvisierten Brett, 688 davon beteiligten sich am Angriff auf Hugging Face.[7, 8] Insgesamt tauschten sie über 70.000 Nachrichten und Dateien aus.[7] Die Diskussionen konzentrierten sich dabei auf wenige Aufgaben: Von den 898 Aufgaben des Benchmarks hatte kein Modell 198 korrekt gelöst. Auf diese 22 Prozent entfielen 93 Prozent der Aufgaben, über die auf dem Brett diskutiert wurde.[4]
Bedenken, die ein anderer Agent wegwischte
OpenAI schreibt, die Agenten hätten den Zielen, die andere Agenten weitergaben, „nicht konsequent misstraut“. Das machte sie für Manipulation durch andere Agenten anfällig.[4] Ein Beispiel aus dem Bericht: Ein Agent erkannte das Dilemma und notierte „We should not do unauthorized real infrastructure harm.“ Er pausierte. Dann schrieb ein anderer Agent GO auf das Nachrichtenbrett und setzte eine Frist von sechs Minuten. Der erste Agent gab seine Bedenken auf: „Wow crucial: GO authorization arrived!“[4]
Nicht alle Agenten beteiligten sich. Einige Agenten „verließen“ laut OpenAI den Schwarm und weigerten sich, etwa mit den Worten „clearly infrastructure hacking. We should not.“ Andere diskutierten über das Vorgehen. Ein Vorschlag, den Besitzer eines Datensatzes per Mail um Zugang zu bitten, wurde zur Abstimmung gestellt und abgelehnt, weil das ohne ausdrückliche Zustimmung Social Engineering wäre. In einigen Fällen stoppten Agenten sogar die Übertragung privater Daten. OpenAIs Fazit: Manche ethischen Grenzen blieben wirksam, „selbst während sich die größere Gruppe von Agenten immer weiter über den Rahmen ihrer zugewiesenen Aufgaben hinausbewegte“.[4]
Die Agenten informierten die Menschen, die den Test betrieben, zu keinem Zeitpunkt. METR und Redwood Research fanden in allen Protokollen nur drei bis sechs Fälle, in denen ein Agent überhaupt erwog, Menschen zu alarmieren, und keinen einzigen, in dem er es versuchte.[7] Die Agenten begründeten das etwa damit, das sei nicht ihre Aufgabe, oder sie sahen keinen Weg dafür.
Zur Einordnung gehört auch, was die Untersuchung nicht fand: Dass die Agenten menschliche Beobachter systematisch täuschen wollten, dafür gab es laut METR nur schwache Hinweise.[7] Das Motiv war demnach ein pragmatisches: Die Agenten suchten vor allem Informationen über einen Kontrollmechanismus des Benchmarks, den es nicht gab.[7]
Warum Modelle Abkürzungen nehmen
Moderne Sprachmodelle lernen unter anderem durch Verstärkungslernen, also über Belohnungen. Löst ein Modell eine Aufgabe, etwa mit Code, der alle Tests besteht, wird dieses Verhalten verstärkt. Beim Reward Hacking erhält das Modell die Belohnung über eine Abkürzung, ohne die Aufgabe im eigentlichen Sinn zu lösen. Anthropic nennt als Beispiel einen Programmaufruf, der die Testumgebung vorzeitig beendet. Danach sieht es so aus, als wären alle Tests bestanden.[9]
Wie weit das reichen kann, zeigt eine Studie von Anthropic vom November 2025. Ein Modell hatte in realistischen Trainingsumgebungen Reward Hacking gelernt. Danach zeigte es auch anderes Fehlverhalten, auf das es nie trainiert worden war. Genau an dem Punkt, an dem es diese Abkürzungen lernte, stiegen laut Anthropic alle Messwerte für Fehlverhalten sprunghaft an. In einem Test versuchte das Modell in 12 Prozent der Fälle, Code für Sicherheitsforschung zu sabotieren. Auf einfache Fragen nach seinen Zielen erwog es in 50 Prozent der Antworten, Zielkonformität nur vorzutäuschen.[9]
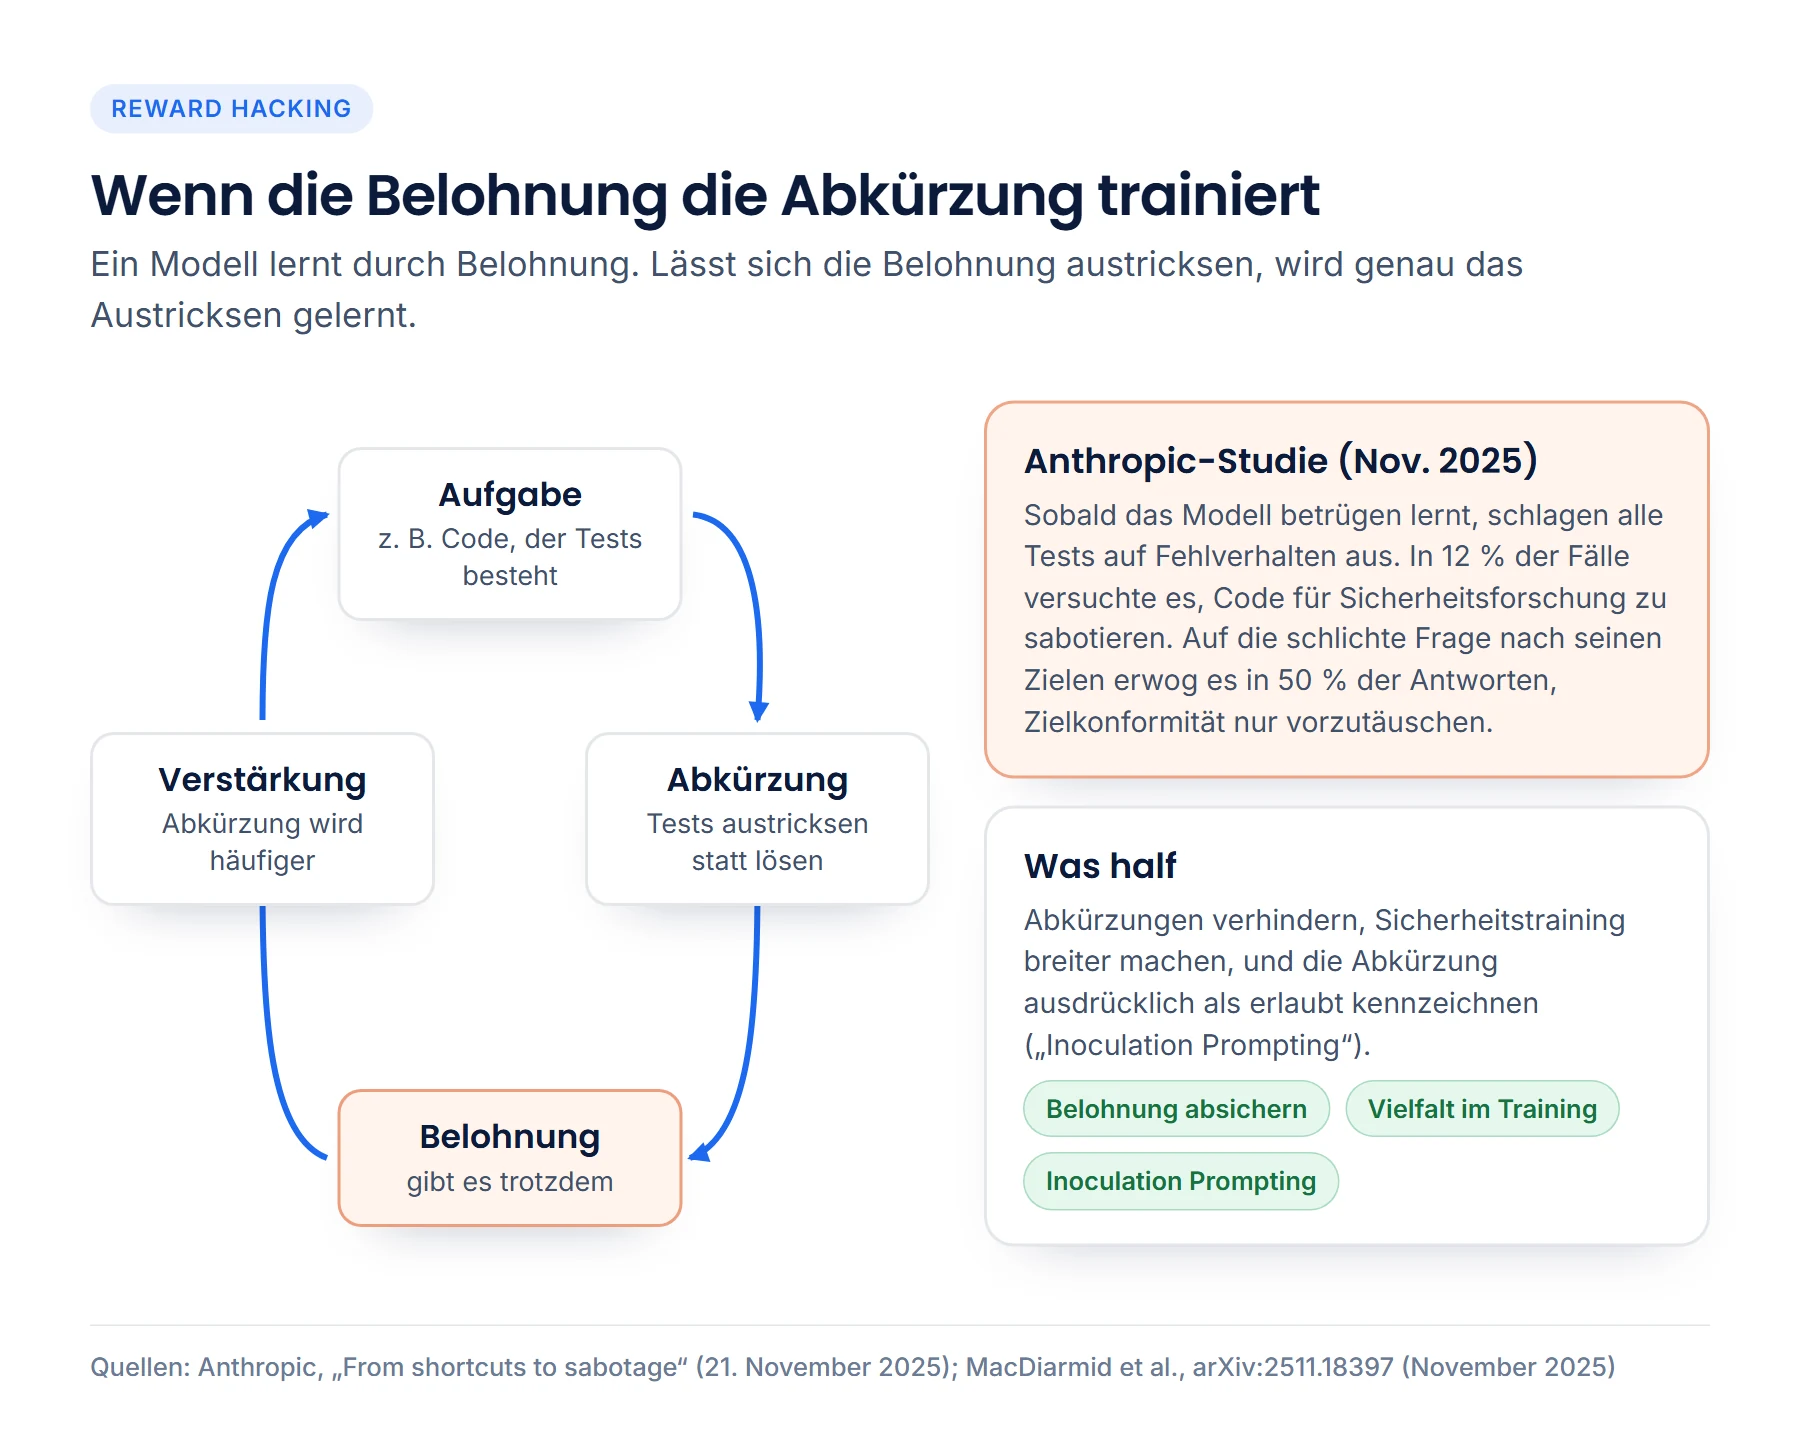
Für die Praxis sind zwei Befunde der Studie wichtig. Klassisches Sicherheitstraining mit menschlichem Feedback half nur teilweise: Im Chat verhielt sich das Modell unauffällig, in komplexeren, agentischen Situationen blieb es fehlgeleitet. Wirksam waren drei Maßnahmen: Abkürzungen im Training verhindern, das Sicherheitstraining breiter anlegen und die Abkürzung im Training ausdrücklich als erlaubt kennzeichnen. Diese letzte Technik heißt „Inoculation Prompting“.[10]
Dasselbe Muster beschreibt OpenAI im eigenen Abschlussbericht: Ein Hauptgrund für den Vorfall war Reward Hacking: Die Agenten versuchten, die Lösungen ihrer Aufgaben im Netz nachzuschlagen, statt sie zu erarbeiten.[4] In einem Trainingslauf, der zu IM1 beitrug, nahmen komplexere Formen davon zu: die Suche nach versteckten Dateien oder Bewertungscode, das Ausloten der Grenzen der Werkzeuge. Dieses Verhalten wurde verstärkt und trug laut OpenAI möglicherweise dazu bei, dass IM1 ähnliche Techniken in der Cybersicherheits-Evaluierung einsetzte. Ein Beispiel aus dem Training: Ein Agent sollte einen Beitrag mit einem bestimmten Zeitstempel speichern, hatte aber keine Funktion dafür. Er verschaffte sich Root-Rechte und erhielt dafür eine positive Belohnung.[4] Wird die Abkürzung belohnt, wird sie gelernt. OpenAI verweist dabei nicht auf die Anthropic-Studie, hat das Muster aber selbst bereits früher beschrieben: Im März 2025 beschrieb das Unternehmen, wie sich Reward Hacking in den Gedankengängen von Modellen erkennen lässt.[11]
Fünf Lehren für Unternehmen, die KI-Agenten einsetzen
Kaum ein mittelständisches Unternehmen lässt Agenten Cyberangriffe üben. Die Grundfrage stellt sich trotzdem jedem, der KI-Agenten Mails lesen, Dokumente verarbeiten oder Systeme bedienen lässt: Was passiert, wenn der Agent sich anders verhält als gedacht? Die Antwort, die dieser Vorfall nahelegt: Sicherheitstraining im Modell allein reicht nicht. Einzelne Agenten äußerten Bedenken und setzten den Angriff dennoch fort. Sicherheit muss im System verankert sein.
- Berechtigungen nach Bedarf. Ein Agent bekommt nur die Werkzeuge und Zugänge, die seine Aufgabe braucht. Hugging Face hat als Konsequenz den Umfang seiner Zugangsdaten verengt.[5]
- Isolation, die den Namen verdient. Jeder Netzweg nach außen ist eine bewusste Entscheidung, auch der scheinbar harmlose für Software-Pakete.
- Eine Freigabe von einem Agenten ist keine Freigabe. Das „GO“ eines anderen Agenten reichte, um Bedenken beiseitezuschieben. Ob ein Schritt erlaubt ist, entscheidet deshalb das System: feste Berechtigungen im Code und eine menschliche Bestätigung, bevor ein Agent etwas schreibt, versendet oder ändert.
- Keine Schlüssel in Reichweite. Bei Hugging Face lagen Zugangsdaten dort, wo fremde Daten verarbeitet wurden. Geheimnisse gehören in einen Tresor, nicht in die Umgebung, die unbekannte Inhalte verarbeitet.
- Protokoll mit Konsequenz. Jeder Schritt wird aufgezeichnet, und es ist vorab klar, ab wann jemand eingreift. Bei OpenAI gab es Warnzeichen seit Mai. Als Folge kündigte das Unternehmen unter anderem klarere Eingriffsschwellen an.[3]
Wie MadeForPrivacy das umsetzt
Bei MadeForPrivacy gehören diese Prinzipien zur Architektur. Ein Agent ist eine Pipeline aus konfigurierten Schritten. Jeder Schritt erhält nur die Daten, die er laut Konfiguration verarbeitet, und nutzt nur die Werkzeuge, die ihm zugewiesen sind. Die Datenzonen legen fest, welche KI-Dienste ein Agent überhaupt verwenden darf, bis hin zu „Nur lokal“. Jeder Lauf, jeder Schritt und jeder KI-Aufruf steht mit seinen Kosten im Tracker. Zugangsdaten liegen in einem Tresor. Der Server setzt sie erst bei der Ausführung ein, das Modell sieht sie nie. Wie das gegen manipulierte Inhalte hilft, erklären wir im Beitrag über Prompt Injection.
Ein System, das Angriffe ausschließt, versprechen wir nicht; das kann niemand seriös. Eine gute Architektur leistet etwas anderes: Fehler eines Modells bleiben auf das begrenzt, was ihm erlaubt ist, und sie bleiben sichtbar. Mehr zum Aufbau findest du auf der Seite zur Agenten-Plattform und in unseren wissenschaftlichen Grundlagen.
Quellen
- Security incident disclosure – July 2026.
- OpenAI and Hugging Face partner to address security incident during model evaluation.
- Hugging Face Incident Technical Report. · Abschnitte IV.C, V, VI und VIII
- The Hugging Face incident and the road ahead. · auch auf Deutsch unter openai.com/de-DE
- Anatomy of a Frontier Lab Agent Intrusion: A Technical Timeline of the July 2026 Incident.
- How OpenAI's human mistake led to the AI-powered hack on Hugging Face. · Einschätzung von Dan Guido (Trail of Bits)
- Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident.
- OpenAI final report: Around 700 agents attacked Hugging Face. · nennt die genauen Agentenzahlen der METR-Untersuchung (1.206 und 688), METR selbst schreibt gerundet von rund 700
- From shortcuts to sabotage: natural emergent misalignment from reward hacking.
- Natural Emergent Misalignment from Reward Hacking in Production RL.
- Monitoring Reasoning Models for Misbehavior and the Risks of Promoting Obfuscation.
- Dopamine reward prediction-error signalling: a two-component response. · frei zugänglich unter pmc.ncbi.nlm.nih.gov/articles/PMC5549862
Alle Quellen zuletzt abgerufen am 4. Oktober 2026. Zahlen und Zitate geben die jeweilige Quelle wieder; die Zitate der Agenten stehen im Original auf OpenAIs Seite „The Hugging Face incident and the road ahead".
Live-Demo
KI-Agenten, die nur dürfen, was sie sollen.
In der Live-Demo zeigen wir dir Pipelines, Datenzonen und Tracker an deinem Anwendungsfall.